Der größte Umbau bisher: BirchEar Model Manager, neue Architektur und Version 3.x.x
Wer meine bisherigen Beiträge zum BirchEar-Projekt verfolgt hat, kennt die Entwicklung: Was ursprünglich als kleines Experiment mit einem Mikrocontroller und einem Mikrofon begann, ist inzwischen zu einer ziemlich umfangreichen Plattform zur Erfassung und KI-gestützten Analyse von Umweltgeräuschen geworden.
Im achten Teil meiner Serie ging es vor allem um die Zuverlässigkeit des Sensors, stabilere WLAN-Verbindungen und bessere Diagnosemöglichkeiten.
Seitdem hat sich allerdings einiges getan. Und diesmal sprechen wir nicht über ein paar zusätzliche Funktionen oder kleinere Optimierungen.
Wir haben die bisher größte strukturelle Änderung am gesamten BirchEar-System vorgenommen.
Im Mittelpunkt steht der neue BirchEar Model Manager (BMM). Dazu kommen eine konsequente Bereinigung der Produktivumgebung, ein neues Entwicklungskonzept und eine klare Aufgabenverteilung zwischen Mensch und künstlicher Intelligenz.
Mit der neuen Versionsgeneration 3.x.x bekommt BirchEar damit ein deutlich robusteres Fundament für zukünftige Erweiterungen.
1. Warum war dieser Umbau überhaupt notwendig?
BirchEar besteht inzwischen aus mehreren Komponenten, die zusammenarbeiten müssen.
Auf der einen Seite befinden sich die eigentlichen Sensoren. Mikrocontroller wie der ESP32/ PICO2W erfassen über ein digitales Mikrofon Umgebungsgeräusche, bereiten das Audiosignal auf und übertragen die Daten über WLAN.
Auf der anderen Seite läuft der BirchEar Receiver. Er nimmt die Daten entgegen, verarbeitet sie weiter und stellt sie für die Analyse und die Benutzeroberfläche bereit.
Für die automatische Geräuscherkennung kommt bisher vor allem YAMNet zum Einsatz. Dabei handelt es sich um ein neuronales Netzwerk zur Klassifizierung von Audiosignalen, das Hunderte unterschiedliche Geräuschklassen erkennen kann.
Das funktioniert bereits erstaunlich gut.
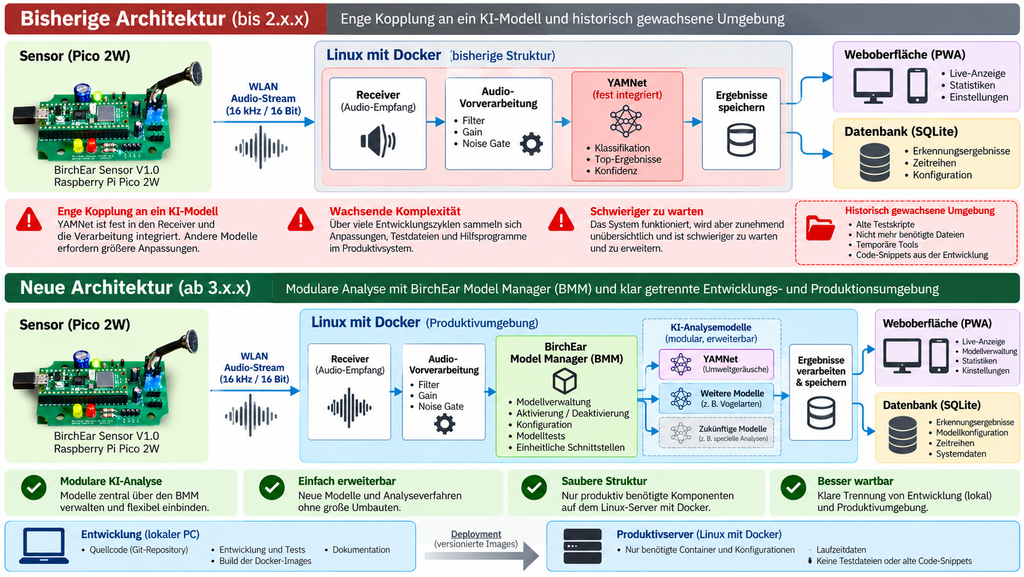
Allerdings hatte die bisherige Architektur einen entscheidenden Nachteil: Die Analyse war relativ eng mit dem verwendeten KI-Modell und den zugehörigen Verarbeitungsschritten verbunden.
Solange nur ein Modell eingesetzt wird, ist das zunächst kein großes Problem. Sobald jedoch weitere Modelle, unterschiedliche Analyseverfahren oder zusätzliche Funktionen hinzukommen sollen, wird diese Kopplung zunehmend hinderlich.
Ein weiteres Problem ist die steigende Komplexität der Software. Über viele Entwicklungszyklen sammeln sich Anpassungen, Testdateien, Hilfsprogramme und gelegentlich auch Codefragmente an, die im produktiven Betrieb überhaupt nicht mehr benötigt werden.
Das System funktioniert zwar weiterhin, wird aber zunehmend schwieriger zu warten.
Genau hier haben wir angesetzt.
2. Der BirchEar Model Manager – was ist das eigentlich?
Die wichtigste Neuerung ist der BMM – BirchEar Model Manager.
Der BMM bildet eine eigenständige logische Schicht zwischen dem Receiver und den eigentlichen KI-Analysemodellen.
Bisher war die Verarbeitung im Wesentlichen auf den Ablauf aus Audioempfang, YAMNet-Auswertung und Speicherung der Ergebnisse ausgelegt.
Mit dem BMM wird diese Struktur aufgebrochen.
Der Receiver muss nicht mehr sämtliche Besonderheiten eines konkreten KI-Modells kennen. Stattdessen übernimmt der Model Manager die Verwaltung und Einbindung der Analysemodelle.
Die neue Verarbeitungskette sieht vereinfacht so aus:
Sensor → Receiver → BMM → KI-Modell → Ergebnisse → Datenbank
Aktuell bleibt YAMNet das zentrale Modell zur Geräuscherkennung. Der entscheidende Unterschied besteht darin, dass es nun über eine definierte Modellverwaltung in die Architektur eingebunden wird.
Was übernimmt der BMM konkret?
Der Model Manager schafft die technische Grundlage, um Analysemodelle zentral zu verwalten.
Dazu gehören insbesondere:
- Modellregistrierung: Analysemodelle werden mit ihren Eigenschaften und ihrer Konfiguration in einer Registry erfasst.
- Aktivierung und Deaktivierung: Modelle können gezielt für die Verarbeitung freigegeben oder deaktiviert werden.
- Modelltests: Die Einbindung eines Modells kann überprüft werden, bevor es regulär eingesetzt wird.
- Einheitliche Anbindung: Der Receiver erhält eine klarere Schnittstelle zur KI-Analyse.
- Erweiterbarkeit: Zusätzliche Modelle lassen sich künftig integrieren, ohne die gesamte Verarbeitungskette neu entwerfen zu müssen.
Auch die Benutzeroberfläche wird entsprechend erweitert.
Im Administrationsbereich gibt es dafür den neuen Bereich „Analysemodelle“. Dort können Modelle verwaltet und getestet werden.
Das klingt auf den ersten Blick vielleicht nach einer relativ kleinen Erweiterung.
Tatsächlich ist es aber ein erheblicher Eingriff in die bestehende Architektur.
Denn es geht nicht nur darum, eine neue Verwaltungsseite zu programmieren. Die komplette Verarbeitung muss weiterhin zuverlässig funktionieren, während gleichzeitig die Verantwortlichkeiten zwischen Receiver, Modellverwaltung, Analyse und Datenspeicherung sauber getrennt werden.
Warum ist das so wichtig?
Ein Beispiel aus der Praxis:
YAMNet ist ein universelles Modell zur Erkennung von Umweltgeräuschen. Es kann beispielsweise Vogelstimmen, Hundegebell, Verkehrslärm und viele andere Geräusche klassifizieren.
Für speziellere Aufgaben wäre es jedoch interessant, weitere Modelle einzusetzen.
Denkbar wären beispielsweise Modelle, die bestimmte Vogelarten unterscheiden oder gezielt technische Geräusche erkennen.
Der BMM ist die Voraussetzung, um solche Erweiterungen künftig strukturiert einzubauen.
Wichtig dabei: Nicht alle denkbaren Erweiterungen sind bereits umgesetzt. Mit Version 3.x.x schaffen wir zunächst die Architektur, auf der solche Funktionen später aufbauen können.
3. Drei Rollen, ein Projekt: Mensch, ChatGPT und IBM BOB
Eine weitere Besonderheit dieses Entwicklungsschrittes ist die Art, wie wir inzwischen zusammenarbeiten.
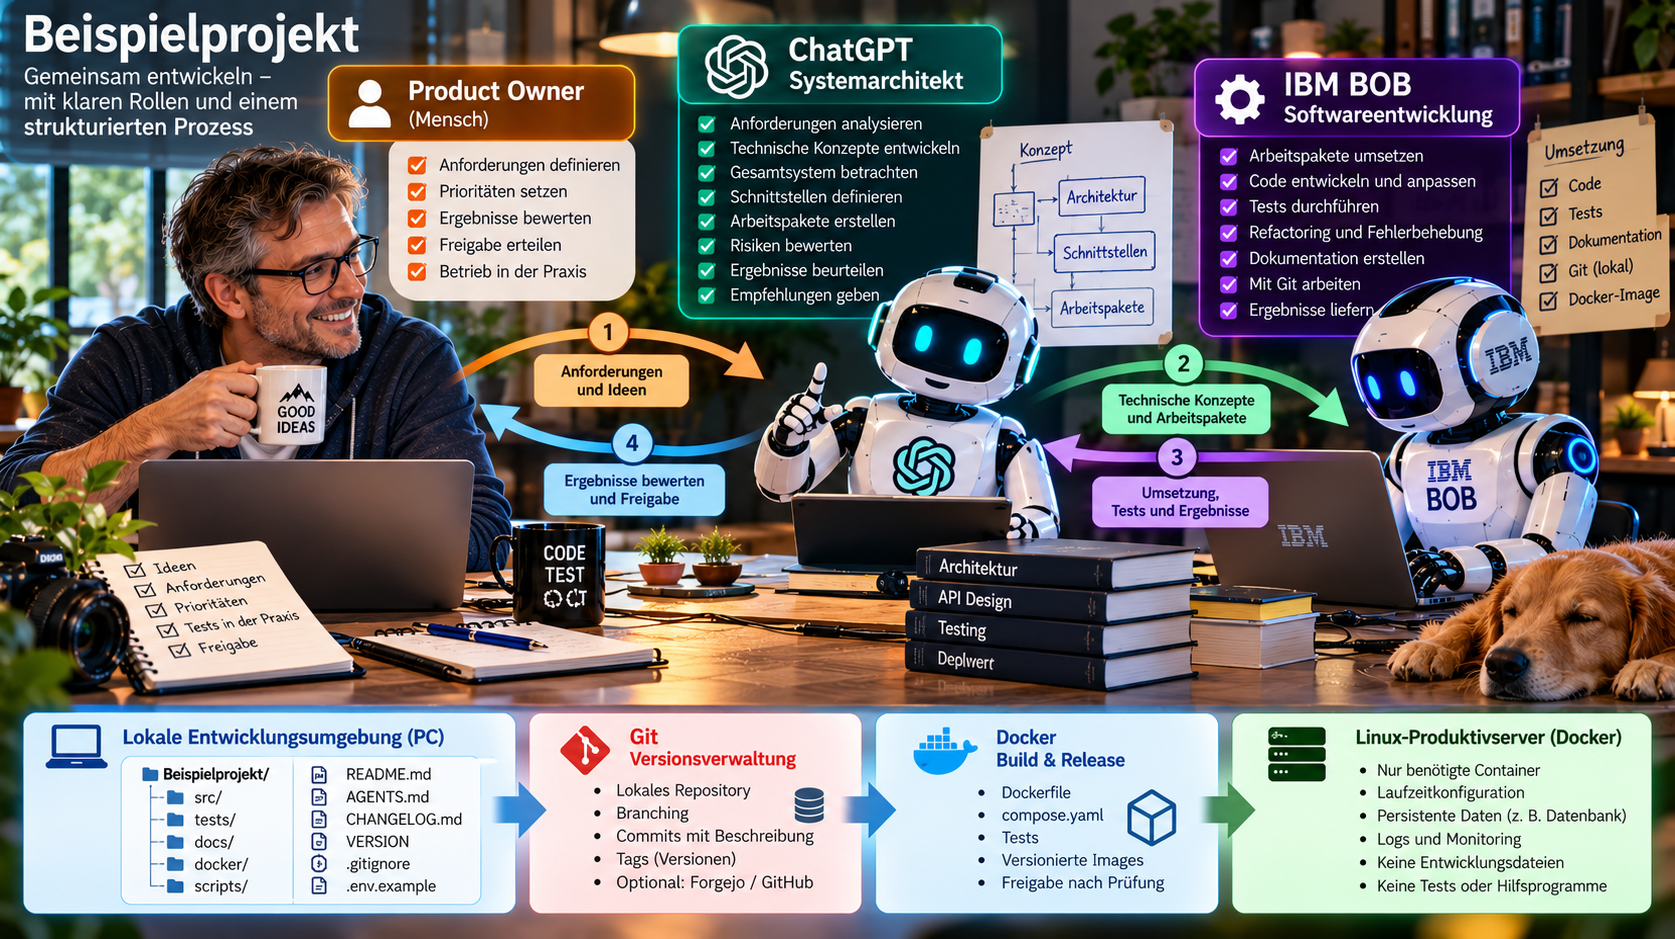
BirchEar wird nicht einfach von einer KI programmiert. Wir haben einen Entwicklungsprozess aufgebaut, bei dem die Verantwortlichkeiten klar verteilt sind.
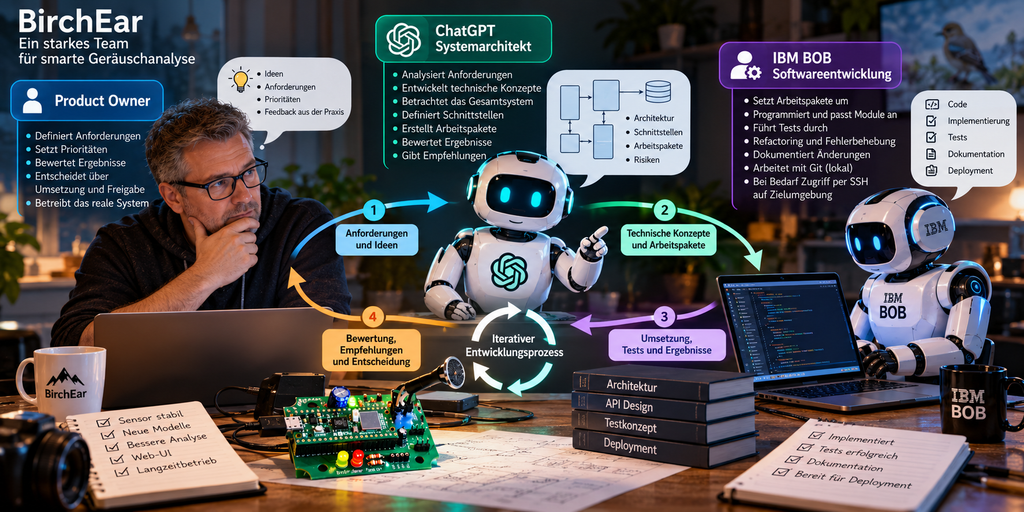
Es gibt drei Rollen:
Product Owner
Das bin ich, also der Mensch in diesem Projekt.
Als Product Owner definiere ich, was BirchEar leisten soll und welche Funktionen tatsächlich benötigt werden.
Ich formuliere die Anforderungen, setze Prioritäten, bewerte die Ergebnisse und entscheide, welche Änderungen umgesetzt werden.
Dazu gehört auch, dass ich das reale System betreibe und beurteile, ob eine Funktion in der Praxis sinnvoll und zuverlässig arbeitet.
Die KI kann Vorschläge machen und technische Lösungen entwickeln. Die Entscheidung über die Anforderungen und die Freigabe liegt jedoch bei mir.
ChatGPT – Systemarchitekt
ChatGPT übernimmt die Rolle des technischen Architekten.
Hier werden meine Anforderungen analysiert und in technische Konzepte übersetzt.
Dabei geht es nicht nur um die Frage, wie eine einzelne Funktion programmiert werden kann.
Viel wichtiger ist die Betrachtung des gesamten Systems:
Wie passen neue Funktionen in die bestehende Architektur? Welche Schnittstellen werden benötigt? Welche Abhängigkeiten entstehen? Welche Risiken müssen berücksichtigt werden?
ChatGPT entwickelt daraus strukturierte Arbeitspakete und technische Vorgaben für die Implementierung.
Außerdem werden Ergebnisse und Rückmeldungen aus der Entwicklung bewertet, um daraus gegebenenfalls neue Anforderungen oder Korrekturen abzuleiten.
IBM BOB – Softwareentwicklung und technische Umsetzung
Die eigentliche programmiertechnische Umsetzung übernimmt IBM BOB, ein KI-gestützter Entwicklungsassistent.
BOB arbeitet mit dem Projektcode, setzt die definierten Arbeitspakete um, passt vorhandene Module an und führt technische Tests durch.
Zu seinen Aufgaben gehören außerdem Refactoring, Fehlerbehebung, Dokumentation und die Arbeit mit der lokalen Git-Versionsverwaltung.
Damit ist BOB gewissermaßen der Softwareentwickler im Team.
Entscheidend ist jedoch: BOB soll nicht eigenständig die grundlegende Systemarchitektur verändern oder neue Produktanforderungen festlegen.
Solche Entscheidungen werden zwischen Product Owner und Systemarchitekt getroffen.
Die Schnittstellen zwischen den Rollen
Besonders interessant finde ich, dass die Zusammenarbeit nicht einfach aus einer Folge von Chat-Prompts besteht.
Wir arbeiten mit definierten Übergaben.
Product Owner → Systemarchitekt
Ich beschreibe Anforderungen, Probleme und gewünschte Funktionen. ChatGPT prüft diese und entwickelt daraus eine technische Lösung.
Systemarchitekt → Softwareentwicklung
ChatGPT erstellt konkrete Arbeitspakete mit Anforderungen, Schnittstellen, technischen Randbedingungen und Prüfkriterien.
Softwareentwicklung → Systemarchitekt
IBM BOB liefert die Umsetzung, Testergebnisse, Dokumentation und Informationen über mögliche Probleme oder offene Punkte zurück.
Systemarchitekt → Product Owner
ChatGPT bewertet die Ergebnisse und erläutert, ob die ursprünglichen Anforderungen erfüllt wurden oder weitere Arbeiten notwendig sind.
Danach entscheide ich, wie es weitergeht.
Dieser Kreislauf wiederholt sich so lange, bis eine Funktion den gewünschten Stand erreicht hat.
Das ist im Prinzip ein kleiner, KI-unterstützter Softwareentwicklungsprozess mit klarer Rollen- und Verantwortungsverteilung.
Und gerade bei einem komplexer werdenden Projekt wie BirchEar ist diese Trennung ausgesprochen hilfreich.
4. Entwicklung und Produktion werden konsequent getrennt
Mit der neuen Architektur haben wir auch unsere Entwicklungsumgebung grundsätzlich überarbeitet.
Bisher lagen auf dem Server neben den produktiv benötigten Dateien teilweise auch Entwicklungsartefakte, Hilfsskripte, Testdateien und andere Bestandteile, die dort eigentlich nichts zu suchen hatten.
Das mag während einer frühen Experimentierphase praktisch sein. Für einen dauerhaft betriebenen Dienst ist es aber keine besonders gute Lösung.
Deshalb gilt jetzt eine klare Regel:
Entwickelt wird ausschließlich lokal auf dem PC. Der Server ist ausschließlich für den produktiven Betrieb zuständig.
Der lokale Entwicklungsrechner
Auf dem PC befinden sich der vollständige Quellcode, das Git-Repository, die Entwicklungsdokumentation sowie die Test- und Build-Umgebung.
Hier arbeitet auch IBM BOB an der Software.
Änderungen können zunächst lokal umgesetzt, geprüft und versioniert werden, ohne unmittelbar in die produktive Umgebung einzugreifen.
Der Produktivserver
Auf meinem Linux-Server läuft die produktive BirchEar-Umgebung auf einer Container Plattform.
Dort sollen ausschließlich die Komponenten liegen, die tatsächlich für den Betrieb erforderlich sind.
Dazu gehören beispielsweise die produktive Docker-Compose-Konfiguration, die benötigten Container-Images, Konfigurationen und Laufzeitdaten.
Nicht auf den Produktivserver gehören dagegen Entwicklungs-Repositories, Testprogramme, Build-Werkzeuge oder umfangreiche Entwicklungsdokumentationen.
Für das Deployment bevorzugen wir fertig erstellte, versionierte Docker-Images.
Damit wird die produktive Umgebung wesentlich übersichtlicher und besser reproduzierbar.
IBM BOB hat trotzdem Zugriff auf den Server
Eine Besonderheit bleibt erhalten.
IBM BOB kann bei Bedarf über eine SSH-Verbindung auf die Zielumgebung zugreifen.
Dieser Zugriff dient jedoch der gezielten Bestandsaufnahme, Diagnose, Überprüfung und kontrollierten Bereitstellung.
Er bedeutet ausdrücklich nicht, dass die Entwicklung wieder auf dem Server stattfindet.
Das ist ein wichtiger Unterschied.
SSH ist ein administrativer Zugang zur Zielplattform und keine Entwicklungsumgebung.
5. Aufräumen gehört ebenfalls zur Softwareentwicklung
Ein weiterer Schwerpunkt ist die Bereinigung der bestehenden Produktivplattform.
Im Laufe eines Projekts sammeln sich zwangsläufig Dateien an, die irgendwann einmal für Tests, Fehlersuche oder Zwischenlösungen benötigt wurden.
Dazu gehören alte Code-Snippets, nicht mehr verwendete Skripte, temporäre Dateien oder überholte Konfigurationen.
Solche Altlasten machen es schwieriger, den tatsächlichen Aufbau des Systems zu verstehen.
Deshalb haben wir die Bereinigung als eigenen Arbeitsschritt eingeplant.
Dabei wird zunächst untersucht, welche Dateien und Verzeichnisse tatsächlich vorhanden sind und welche Funktionen sie erfüllen.
Anschließend wird unterschieden zwischen produktiv benötigten Bestandteilen und entbehrlichen Entwicklungsartefakten.
Wichtig ist, dass eine solche Bereinigung nicht einfach durch das pauschale Löschen vermeintlich überflüssiger Dateien erfolgt.
Gerade bei Docker-Umgebungen können Konfigurationen, persistente Daten und eingebundene Verzeichnisse voneinander abhängen.
Deshalb muss vor einer Bereinigung geklärt werden, welche Komponenten tatsächlich noch benötigt werden.
Ziel ist eine schlanke, nachvollziehbare Produktivumgebung, ohne den laufenden Betrieb oder bestehende Daten zu gefährden.
6. Warum der Umbau so komplex ist
Die Einführung des BMM ist keine isolierte Programmieraufgabe.
Sie betrifft mehrere Ebenen des Systems gleichzeitig.
Der Datenfluss vom Sensor bis zur KI-Auswertung muss weiterhin funktionieren. Gleichzeitig müssen die Schnittstellen zwischen Receiver und Modellverwaltung neu strukturiert werden.
Hinzu kommen die Modellkonfiguration, die Verwaltung der aktiven Modelle, die Speicherung der Analyseergebnisse und die Einbindung in die Administrationsoberfläche.
Auch die Sicherheit spielt eine wichtige Rolle.
Beispielsweise muss verhindert werden, dass Modellpfade unkontrolliert auf Dateien außerhalb der vorgesehenen Verzeichnisse zugreifen können. Ebenso muss sichergestellt werden, dass Modellkennungen und Datenbankzuordnungen konsistent bleiben.
Besonders anspruchsvoll ist dabei, eine bestehende funktionierende Anwendung umzubauen, ohne die bereits vorhandenen Funktionen zu beschädigen.
Ein neues System auf der grünen Wiese zu entwickeln, wäre an manchen Stellen sogar einfacher.
Bei BirchEar müssen wir dagegen vorhandene Komponenten, Daten und Abläufe berücksichtigen.
Deshalb wird der Umbau in klar abgegrenzten Arbeitspaketen durchgeführt.
Jeder Schritt wird implementiert, geprüft und dokumentiert, bevor die nächste Änderung folgt.
7. BirchEar 3.x.x – die neue Versionsgeneration
Mit dem Architekturumbau beginnt für BirchEar die Versionsgeneration 3.x.x.
Die Versionsnummer steht für eine grundlegende Weiterentwicklung der Plattform.
Die wichtigsten Veränderungen lassen sich so zusammenfassen:
| Bereich | Bisher | Neue Architektur |
|---|---|---|
| KI-Analyse | Starke Ausrichtung auf YAMNet | Zentrale Modellverwaltung über BMM |
| Erweiterbarkeit | Neue Modelle erfordern größere Anpassungen | Definierte Grundlage für zusätzliche Modelle |
| Administration | Analysefunktionen enger in das System eingebunden | Eigener Bereich für Analysemodelle |
| Entwicklung | Entwicklungs- und Serverartefakte teilweise vermischt | Lokale Entwicklung mit Git und Tests |
| Produktion | Historisch gewachsene Dateistruktur | Reduzierte, betriebsorientierte Umgebung |
| Deployment | Teilweise direkte Arbeit an der Zielumgebung | Versionierte Docker-Images als bevorzugter Weg |
| Zusammenarbeit | KI-gestützte Entwicklung | Klare Rollen und strukturierte Arbeitspakete |
Die Umstellung erfolgt schrittweise. Insbesondere die Absicherung der Modellverwaltung, die Bereinigung der Produktionsumgebung und die kontrollierte Bereitstellung müssen sorgfältig abgeschlossen und geprüft werden.
Die Versionsgeneration 3.x.x ist deshalb nicht nur ein neues Etikett, sondern ein technischer Neuanfang auf Basis des bereits funktionierenden Systems.
8. Was bringt das Ganze konkret?
Der größte Vorteil liegt nicht in einer einzelnen neuen Funktion.
Es geht darum, BirchEar langfristig besser weiterentwickeln zu können.
Durch den BMM wird die KI-Analyse flexibler. Neue Modelle können zukünftig deutlich strukturierter eingebunden werden.
Durch die Trennung von Entwicklung und Produktion sinkt das Risiko, dass experimentelle Änderungen den produktiven Betrieb beeinträchtigen.
Durch die Bereinigung der Zielplattform wird die gesamte Umgebung übersichtlicher und leichter wartbar.
Und durch die klare Aufteilung der Verantwortlichkeiten zwischen Georg, ChatGPT und IBM BOB wird auch die Softwareentwicklung besser kontrollierbar.
Das bedeutet natürlich nicht, dass KI-generierter Code automatisch fehlerfrei ist.
Ganz im Gegenteil: Je komplexer das System wird, desto wichtiger werden nachvollziehbare Anforderungen, definierte Schnittstellen, Tests und eine kritische Prüfung der Ergebnisse.
Genau deshalb ist der menschliche Product Owner weiterhin eine zentrale Instanz im gesamten Prozess.
9. Fazit und Ausblick
Wenn ich mir anschaue, wie BirchEar ursprünglich angefangen hat, ist die Entwicklung schon ziemlich bemerkenswert.
Aus einem Mikrocontroller mit Mikrofon und WLAN ist eine verteilte Plattform mit Receiver, Datenbank, Weboberfläche und KI-gestützter Geräuscherkennung geworden.
Mit dem BirchEar Model Manager gehen wir nun einen weiteren wichtigen Schritt.
Die Plattform wird nicht einfach um eine weitere Funktion ergänzt, sondern strukturell auf zukünftige Anforderungen vorbereitet.
Mindestens genauso spannend finde ich allerdings die Zusammenarbeit zwischen Mensch und KI.
Ein menschlicher Product Owner definiert die Ziele und trifft Entscheidungen. ChatGPT entwickelt die technische Architektur und strukturiert die Umsetzung. IBM BOB implementiert die Software, führt Tests durch und dokumentiert die Ergebnisse.
Dieses Zusammenspiel funktioniert besonders dann gut, wenn Verantwortlichkeiten und Schnittstellen eindeutig festgelegt sind.
BirchEar 3.x.x ist deshalb für mich mehr als nur ein Softwareupdate. Es ist der Übergang von einem gewachsenen Hobbyprojekt zu einer zunehmend professionell organisierten IoT- und KI-Plattform.
Und eines ist sicher: Die Ideen für weitere Funktionen gehen uns so schnell nicht aus.
Fortsetzung folgt …




Hinterlasse einen Kommentar