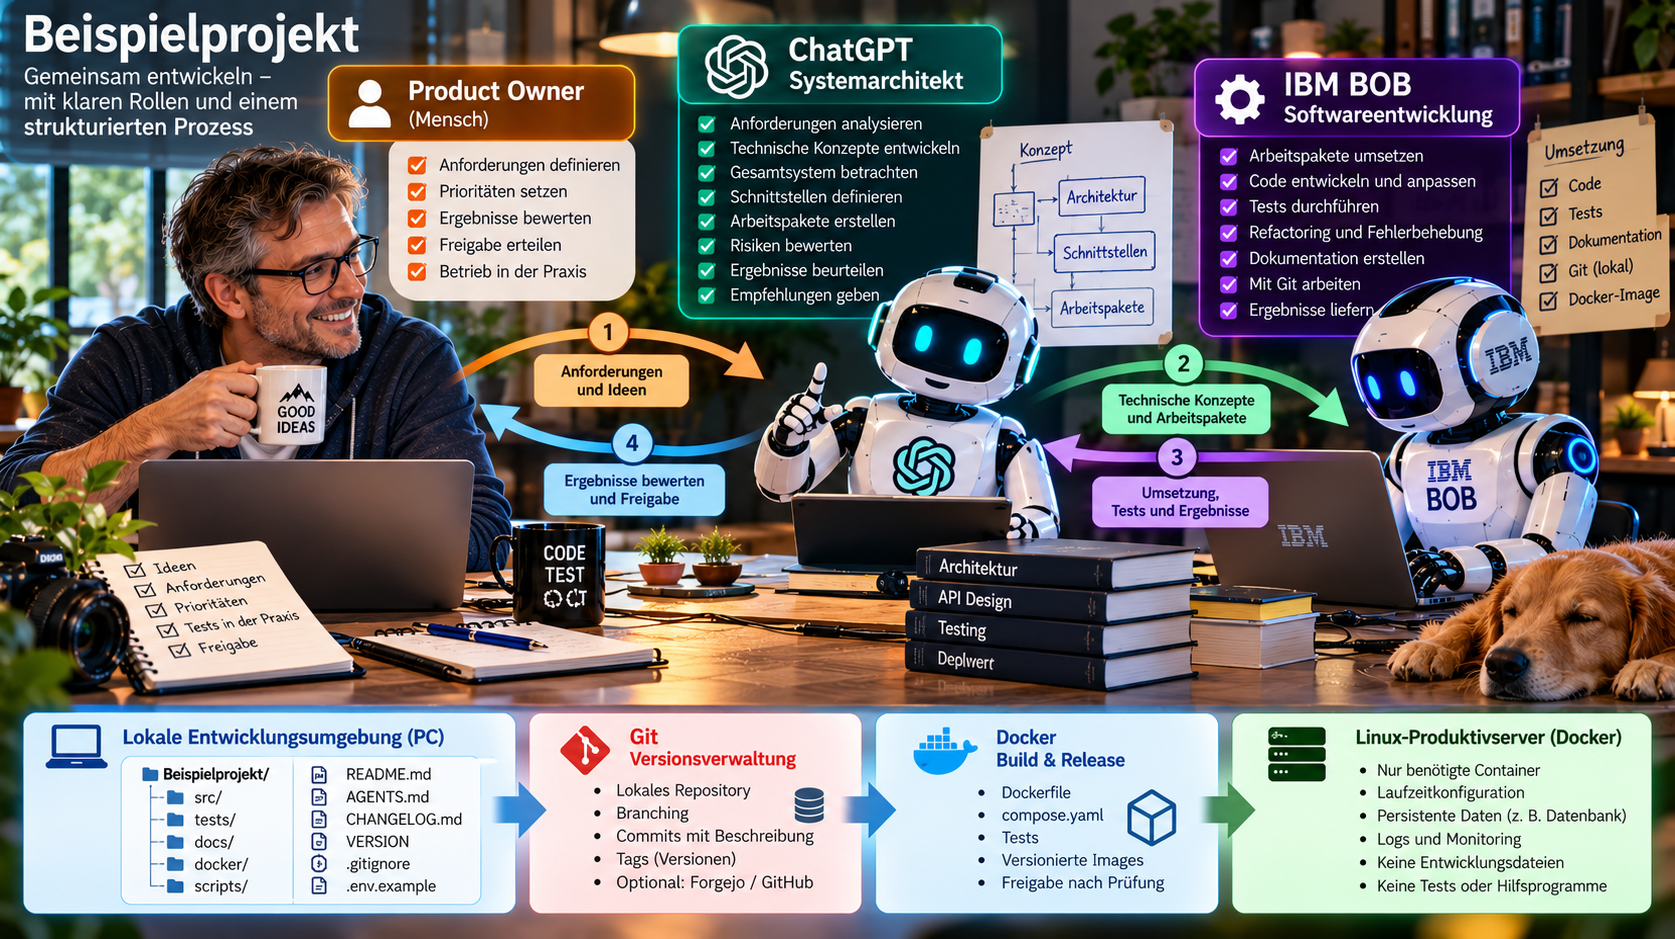
Von AGENTS.md über Git bis Docker: So organisiert man eine moderne Entwicklungsumgebung
Wer heute Software entwickelt, hat deutlich mehr Möglichkeiten als noch vor wenigen Jahren. Insbesondere KI-gestützte Entwicklungsassistenten wie IBM BOB, GitHub Copilot oder andere Coding-Tools können inzwischen umfangreiche Programmieraufgaben übernehmen.
Doch mit der Geschwindigkeit, mit der neuer Programmcode entsteht, wachsen auch die Anforderungen an die Organisation eines Softwareprojekts.
Wo liegt der aktuelle Quellcode? Welche Änderungen wurden vorgenommen? Welche Version läuft produktiv? Welche Regeln muss ein KI-Assistent beachten? Und wie verhindert man, dass unfertiger Programmcode versehentlich auf einem Produktivserver landet?
Genau darum geht es in diesem Beitrag.
Anhand eines fiktiven Projekts mit dem Namen „Beispielprojekt“ schauen wir uns an, wie eine übersichtliche, nachvollziehbare und langfristig wartbare Entwicklungsumgebung aufgebaut werden kann.
Der Beitrag richtet sich an technisch interessierte Leser mit grundlegenden Kenntnissen in IT und Programmierung. Wer eigene Mikrocontroller-, IoT-, Web- oder KI-Projekte entwickelt, kann die vorgestellten Prinzipien direkt übernehmen.
1. Warum eine saubere Entwicklungsumgebung so wichtig ist
Viele Softwareprojekte beginnen recht unkompliziert.
Ein Verzeichnis wird angelegt, die ersten Programmdateien entstehen und nach kurzer Zeit funktioniert bereits eine erste Version.
Mit jeder Erweiterung kommen weitere Dateien hinzu. Es entstehen Hilfsprogramme, Testskripte, Konfigurationsdateien und Dokumentationen.
Irgendwann stellt sich die Frage: Welche Dateien werden eigentlich noch benötigt?
Besonders bei der Entwicklung mit KI-Assistenten kann dieses Problem schnell auftreten. Die KI erzeugt Code, verändert vorhandene Module und ergänzt neue Funktionen. Ohne verbindliche Regeln kann dabei eine Struktur entstehen, die zwar funktioniert, aber immer schwieriger zu verstehen ist.
Eine professionelle Entwicklungsumgebung sollte deshalb vier grundlegende Anforderungen erfüllen:
- Nachvollziehbarkeit: Jede relevante Änderung lässt sich einer Version zuordnen.
- Reproduzierbarkeit: Ein bestimmter Softwarestand kann erneut erstellt und bereitgestellt werden.
- Wartbarkeit: Quellcode, Tests und Dokumentation sind sinnvoll organisiert.
- Sicherheit: Entwicklungsarbeiten und produktiver Betrieb sind klar voneinander getrennt.
Dafür braucht es nicht unbedingt teure Werkzeuge oder eine umfangreiche Infrastruktur.
Oft reichen ein geeigneter Editor, Git, einige gut gepflegte Markdown-Dateien und klare Entwicklungsregeln.
2. Wie sollte ein Softwareprojekt aufgebaut sein?
Betrachten wir unser fiktives „Beispielprojekt“.
Es besteht aus einer Anwendung, einer kleinen Weboberfläche und einer Datenbank. Die Anwendung soll später auf einem Linux-Server in Docker-Containern laufen.
Eine mögliche Verzeichnisstruktur sieht folgendermaßen aus:
Beispielprojekt/
│
├── AGENTS.md
├── README.md
├── CHANGELOG.md
├── VERSION
├── .gitignore
├── .env.example
│
├── src/
│   ├── backend/
│   ├── frontend/
│   └── database/
│
├── tests/
│   ├── unit/
│   └── integration/
│
├── docs/
│   ├── architecture/
│   ├── development/
│   └── deployment/
│
├── docker/
│   └── Dockerfile
│
├── compose.yaml
│
└── scripts/
    ├── build/
    └── deployment/
Das ist keine zwingende Verzeichnisstruktur, sondern ein praktikables Beispiel.
Ein kleines Python-Programm benötigt möglicherweise nur wenige Dateien. Eine umfangreiche Anwendung mit Datenbank, API und Weboberfläche dagegen profitiert von einer stärkeren Aufteilung.
Entscheidend ist, dass jedes Verzeichnis einen eindeutigen Zweck besitzt.
Die eigentliche Software befindet sich unter src/. Automatisierte Tests liegen unter tests/. Technische Dokumentationen werden unter docs/ abgelegt.
Die Dateien im Hauptverzeichnis beschreiben das Projekt, seine Versionierung und die geltenden Entwicklungsregeln.
3. README.md – die Visitenkarte des Projekts
Die Datei README.md ist normalerweise der erste Einstiegspunkt in ein Softwareprojekt.
Sie sollte mindestens folgende Fragen beantworten:
- Was macht die Software?
- Welche Voraussetzungen müssen erfüllt sein?
- Wie wird die Entwicklungsumgebung eingerichtet?
- Wie wird das Programm gestartet?
- Wie können Tests ausgeführt werden?
- Wo befinden sich weiterführende Informationen?
Die Endung .md steht für Markdown. Dabei handelt es sich um ein einfaches Textformat, das Überschriften, Tabellen, Links und Codebeispiele unterstützt.
Markdown-Dateien können beispielsweise direkt in Visual Studio Code bearbeitet werden.
Auch Plattformen wie GitHub, GitLab oder Forgejo stellen diese Dateien automatisch formatiert dar.
Eine gut gepflegte README spart viel Zeit. Nicht nur anderen Entwicklern, sondern auch einem selbst, wenn man nach einigen Monaten wieder an einem Projekt arbeitet.
4. AGENTS.md – Spielregeln für KI-Entwicklungsassistenten
Eine besonders interessante Datei ist AGENTS.md.
Während eine README in erster Linie das Projekt beschreibt, richtet sich eine AGENTS-Datei an KI-gestützte Entwicklungswerkzeuge.
Sie kann festlegen, welche Regeln ein KI-Assistent bei der Bearbeitung des Quellcodes beachten soll.
Für unser Beispielprojekt könnten darin folgende Vorgaben stehen:
# AGENTS.md – Beispielprojekt

## Projektregeln

- Quellcode ausschließlich lokal entwickeln.
- Bestehende Architektur berücksichtigen.
- Keine Änderungen ohne definierten Auftrag.
- Neue Funktionen durch Tests absichern.
- Dokumentation bei Änderungen aktualisieren.

## Versionierung

- Semantic Versioning verwenden.
- Versionsnummer bei Releases aktualisieren.
- CHANGELOG.md pflegen.

## Git

- Änderungen in nachvollziehbaren Commits speichern.
- Aussagekräftige Commit-Nachrichten verwenden.
- Keine Passwörter oder Zugangsdaten committen.

## Deployment

- Produktivserver nicht als Entwicklungsumgebung nutzen.
- Docker-Images lokal oder in einer CI-Umgebung bauen.
- Deployment nur nach Freigabe.
Der Vorteil liegt auf der Hand: Ein KI-Assistent erhält ein Regelwerk, das unabhängig von einer einzelnen Programmieraufgabe gilt.
Allerdings ist AGENTS.md kein universell verpflichtender Standard. Die Unterstützung hängt vom verwendeten Werkzeug ab. Gegebenenfalls müssen die Anweisungen ausdrücklich eingebunden werden.
Außerdem ersetzen solche Regeln keine technischen Schutzmaßnahmen. Ein KI-Assistent sollte beispielsweise nicht allein deshalb uneingeschränkte Administratorrechte erhalten, weil in einer Datei steht, dass er vorsichtig arbeiten soll.
Eine AGENTS.md definiert Arbeitsregeln, ersetzt aber weder Tests noch eine Zugriffskontrolle.
Eine weitere wichtige Überlegung betrifft die verschiedenen Arbeitsmodi von KI-Entwicklungsassistenten. Die Regeln in AGENTS.md sollten unabhängig davon gelten, ob die KI gerade Anforderungen analysiert, eine Architektur plant oder im Agent-Modus aktiv Programmcode verändert.
Dabei können für einzelne Tätigkeiten unterschiedliche Berechtigungen sinnvoll sein. Während eine Architekturplanung normalerweise keinen Schreibzugriff benötigt, muss ein Entwicklungsagent Dateien verändern und Tests ausführen können.
Die Projektregeln bleiben gleich – die erlaubten Aktionen hängen von der jeweiligen Aufgabe ab.
5. CHANGELOG.md – die Entwicklung nachvollziehbar machen
Während Git einzelne Änderungen am Quellcode dokumentiert, beschreibt die Datei CHANGELOG.md die wesentlichen Veränderungen zwischen Softwareversionen.
Ein Beispiel:
# Changelog

## [1.2.0] - 2026-10-18

### Added
- Neue Administrationsoberfläche
- Erweiterte Konfigurationsmöglichkeiten

### Changed
- Datenbankzugriff optimiert

### Fixed
- Fehler bei der Anmeldung behoben

## [1.1.0]

### Added
- Erste Version der Weboberfläche
Ein Changelog sollte vor allem aus Sicht der Anwender und Betreiber verständlich sein.
Es dokumentiert nicht jede einzelne Codezeile, sondern die relevanten Änderungen einer Version.
Bei umfangreicheren Projekten kann zusätzlich eine technische Entwicklungsdokumentation sinnvoll sein, in der Architekturentscheidungen und größere Umbauten detaillierter beschrieben werden.
6. Versionierung mit Semantic Versioning
Eine Softwareversion sollte eindeutig identifizierbar sein.
Ein weitverbreitetes Verfahren ist Semantic Versioning, abgekürzt SemVer.
Dabei besteht eine Versionsnummer aus drei Teilen:
MAJOR.MINOR.PATCH
Nehmen wir als Beispiel die Version 2.4.7.
| Bestandteil | Wert | Bedeutung |
|---|---|---|
| Major | 2 | Hauptversion, erhöht bei inkompatiblen Änderungen der öffentlichen Schnittstelle |
| Minor | 4 | Neue, rückwärtskompatible Funktionen |
| Patch | 7 | Rückwärtskompatible Fehlerkorrekturen |
Wenn eine Anwendung eine neue Funktion erhält, ohne bestehende Schnittstellen zu verändern, kann beispielsweise aus 2.4.7 die Version 2.5.0 werden.
Wird lediglich ein Fehler behoben, könnte die nächste Version 2.4.8 lauten.
Eine inkompatible Änderung an einer öffentlichen Schnittstelle würde dagegen eine neue Major-Version rechtfertigen.
Für die eigentliche Versionsverwaltung gibt es unterschiedliche Möglichkeiten.
Man kann beispielsweise eine Datei VERSION verwenden, die lediglich die aktuelle Versionsnummer enthält.
Wichtig ist, dass die Version konsistent bleibt: im Quellcode, im Git-Tag, im Docker-Image und gegebenenfalls in der Benutzeroberfläche.
7. Git – das Gedächtnis der Softwareentwicklung
Git gehört zu den wichtigsten Werkzeugen moderner Softwareentwicklung.
Es handelt sich um ein verteiltes Versionsverwaltungssystem, das Veränderungen an Dateien nachvollziehbar speichert.
Jeder sogenannte Commit stellt einen dokumentierten Entwicklungsschritt dar.
Ein typischer Ablauf könnte so aussehen:
git init

git add .

git commit -m "Initiale Projektstruktur"

# Nach einer späteren Änderung

git add .

git commit -m "Neue Benutzerverwaltung implementiert"

# Freigegebene Version markieren

git tag v1.1.0
Mit Git lässt sich jederzeit nachvollziehen, welche Dateien verändert wurden.
Auch ältere Entwicklungsstände können wiederhergestellt oder miteinander verglichen werden.
Git und ein zentraler Repository-Server
Git funktioniert zunächst vollständig lokal.
Zusätzlich kann ein zentraler Server eingesetzt werden, beispielsweise GitHub, GitLab oder ein selbst betriebener Forgejo-Server.
Dieser dient als gemeinsamer Ablageort für den Quellcode und ermöglicht weitere Funktionen wie Branches, Pull Requests, Issues und automatisierte Entwicklungsprozesse.
Wichtig ist die Unterscheidung:
Git ist das Versionsverwaltungssystem. GitHub, GitLab und Forgejo sind Plattformen, die Git-Repositories verwalten und zusätzliche Funktionen anbieten.
Für ein gut organisiertes Projekt empfiehlt sich außerdem, neue Funktionen zunächst in separaten Branches zu entwickeln.
So bleibt der freigegebene Entwicklungsstand geschützt, während an neuen Funktionen gearbeitet wird.
8. .gitignore – was nicht ins Repository gehört
Nicht jede Datei sollte mit Git versioniert werden.
Dazu gehören beispielsweise temporäre Dateien, lokale Entwicklungsumgebungen, generierte Build-Ergebnisse und insbesondere Zugangsdaten.
Hier kommt .gitignore ins Spiel.
Eine solche Datei könnte beispielsweise enthalten:
# Python
__pycache__/
.venv/

# Lokale Konfiguration
.env
.env.local

# Temporäre Dateien
*.tmp
*.log

# Build-Ergebnisse
dist/
build/

# Editor
.vscode/
Dabei sollte man beachten, dass .gitignore nur verhindert, dass passende, noch nicht versionierte Dateien versehentlich aufgenommen werden.
Bereits von Git verwaltete Dateien werden dadurch nicht automatisch entfernt.
Eine Datei .env.example ist dagegen sinnvoll, um benötigte Konfigurationsparameter zu dokumentieren, ohne echte Passwörter oder API-Schlüssel zu veröffentlichen.
9. Tests – Änderungen müssen überprüfbar sein
Eine saubere Projektstruktur sollte auch eine Teststrategie enthalten.
Dabei unterscheidet man beispielsweise zwischen Unit-Tests, Integrationstests und End-to-End-Tests.
Unit-Tests überprüfen einzelne Funktionen oder Module.
Integrationstests kontrollieren, ob mehrere Komponenten korrekt zusammenarbeiten.
End-to-End-Tests betrachten größere Abläufe aus Sicht des Anwenders.
Gerade bei KI-generiertem Programmcode sind automatisierte Tests besonders wichtig.
Denn eine KI kann Code erzeugen, der auf den ersten Blick plausibel erscheint, aber unter bestimmten Bedingungen nicht korrekt funktioniert.
Idealerweise wird deshalb bereits bei der Formulierung eines Arbeitspakets festgelegt, wie sich die erfolgreiche Umsetzung überprüfen lässt.
10. Docker – Entwicklung und Produktion trennen
Für unser Beispielprojekt verwenden wir Docker.
Dabei wird die Anwendung zusammen mit ihren benötigten Laufzeitkomponenten in einem Container-Image bereitgestellt.
Der eigentliche Quellcode wird auf dem Entwicklungsrechner bearbeitet.
Dort befinden sich auch die Tests, die Dokumentation und die Versionsverwaltung.
Auf dem Produktivserver sollen dagegen nur die Komponenten liegen, die tatsächlich für den Betrieb benötigt werden.
Dazu gehören:
- Fertige Container-Images
- Produktive Docker-Compose-Konfiguration
- Erforderliche Umgebungsvariablen und Geheimnisse
- Persistente Anwendungsdaten
- Betriebsrelevante Protokolle
Nicht auf den Produktivserver gehören dagegen vollständige Entwicklungs-Repositories, Build-Werkzeuge oder nicht benötigte Testskripte.
Ein möglicher Ablauf ist:
Entwicklung → Tests → Git-Commit → Release → Docker-Build → Deployment
Dabei sollten Docker-Images eindeutige Versionskennungen erhalten.
Ein Image mit der Kennung beispielprojekt:1.2.0 lässt sich einem konkreten Softwarestand zuordnen.
Für besonders zuverlässige Deployments kann zusätzlich ein unveränderlicher Image-Digest verwendet werden.
11. KI-gestützte Entwicklung braucht klare Verantwortlichkeiten
11. KI-gestützte Entwicklung: Plattformen, Arbeitsmodi und Verantwortlichkeiten
Bei der KI-gestützten Softwareentwicklung stellt sich eine interessante Frage: Sollte ein einziges KI-System sämtliche Aufgaben übernehmen, oder ist es sinnvoller, unterschiedliche KI-Systeme einzusetzen?
Grundsätzlich können moderne KI-Entwicklungsassistenten mehrere Aufgaben übernehmen. Sie können Anforderungen analysieren, Softwarearchitekturen entwerfen, Programmcode schreiben, Tests ausführen und Ergebnisse überprüfen.
Entscheidend ist deshalb nicht unbedingt, welche KI-Plattform verwendet wird, sondern in welcher Rolle und mit welchen Berechtigungen sie arbeitet.
KI-Plattform, Arbeitsmodus und Projektrolle
Hier sollte man drei Dinge unterscheiden:
| Ebene | Bedeutung | Beispiele |
|---|---|---|
| KI-Plattform | Das verwendete KI-System oder Entwicklungswerkzeug | ChatGPT, IBM BOB, GitHub Copilot |
| Arbeitsmodus | Die Art, wie eine Aufgabe bearbeitet wird | Ask, Plan, Agent |
| Projektrolle | Die Verantwortung innerhalb des Projekts | Systemarchitekt, Entwickler, Reviewer |
Viele moderne Entwicklungsassistenten unterstützen vergleichbare Arbeitsweisen, auch wenn die Funktionen nicht überall identisch heißen.
Ask-Modus: Die KI beantwortet Fragen, analysiert Probleme und erklärt vorhandenen Programmcode. Änderungen am Projekt werden normalerweise nicht vorgenommen.
Plan-Modus: Die KI entwickelt technische Konzepte, analysiert Abhängigkeiten, definiert Schnittstellen und erstellt konkrete Arbeitspakete.
Agent-Modus: Die KI kann aktiv mit der Entwicklungsumgebung arbeiten, Dateien verändern, Programmcode erzeugen und Tests ausführen. Welche Aktionen tatsächlich möglich sind, hängt von den verfügbaren Werkzeugen und Berechtigungen ab.
Ein KI-System oder mehrere?
Für kleinere Softwareprojekte kann es vollkommen ausreichen, ein einziges KI-System einzusetzen.
Der Mensch formuliert die Anforderungen. Die KI analysiert sie zunächst im Plan-Modus, setzt sie anschließend im Agent-Modus um und unterstützt danach bei der Überprüfung.
Bei umfangreicheren Projekten kann es dagegen sinnvoll sein, unterschiedliche KI-Systeme einzusetzen.
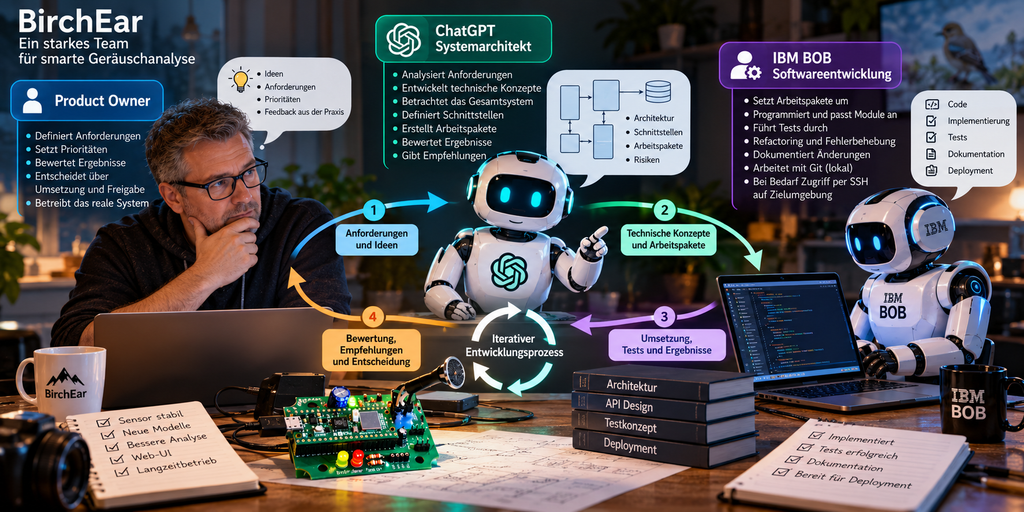
Beispielsweise könnte ChatGPT die Systemarchitektur entwickeln, während IBM BOB die programmiertechnische Umsetzung übernimmt.
Ein zweites KI-System kann anschließend die Implementierung überprüfen und mögliche Schwachstellen aufzeigen.
Eine solche Aufteilung bietet zusätzliche Kontrollmöglichkeiten, verursacht allerdings auch mehr Abstimmungsaufwand.
Klare Rollen sind wichtiger als unterschiedliche Plattformen
Unabhängig davon, wie viele KI-Systeme eingesetzt werden, sollte es eindeutige Verantwortlichkeiten geben.
Product Owner (Mensch): Definiert Anforderungen, setzt Prioritäten, bewertet Ergebnisse und erteilt Freigaben.
Systemarchitekt (Mensch oder KI): Entwickelt technische Konzepte, definiert Schnittstellen, analysiert Risiken und erstellt Arbeitspakete.
Softwareentwickler (Mensch oder KI): Implementiert Funktionen, schreibt Tests, dokumentiert Änderungen und arbeitet mit der Versionsverwaltung.
Reviewer (Mensch oder KI): Überprüft die Ergebnisse anhand der Anforderungen, Architekturvorgaben und Testergebnisse.
Ein KI-System kann mehrere dieser Rollen übernehmen. Es ist jedoch sinnvoll, die einzelnen Arbeitsschritte bewusst voneinander zu trennen.
Besonders bei kritischen Änderungen sollte die Qualitätskontrolle möglichst unabhängig von der eigentlichen Implementierung erfolgen.
Fazit zur Rollenverteilung
Die optimale Zusammenarbeit hängt von der Größe und Komplexität des Projekts ab.
Bei kleinen Projekten reicht häufig ein einzelner KI-Assistent mit unterschiedlichen Arbeitsmodi.
Bei komplexeren Anwendungen können mehrere KI-Systeme mit getrennten Aufgaben zusätzliche Vorteile bieten.
Nicht die Anzahl der eingesetzten KI-Systeme entscheidet über die Qualität, sondern klare Verantwortlichkeiten, definierte Schnittstellen, nachvollziehbare Entscheidungen und überprüfbare Ergebnisse.
Die endgültige Verantwortung für die Software und ihre Freigabe bleibt beim Menschen.
12. Was ist Pflicht, was ist optional?
Zum Abschluss noch eine praktische Übersicht:
| Bestandteil | Empfehlung |
|---|---|
| Strukturierte Quellcode-Verzeichnisse | Grundlegend |
README.md | Sehr empfehlenswert |
| Git | Für ernsthafte Entwicklungsprojekte praktisch unverzichtbar |
.gitignore | Bei Git-Projekten dringend empfohlen |
AGENTS.md | Sinnvoll bei unterstützten KI-Coding-Assistenten |
CHANGELOG.md | Besonders für versionierte Releases |
VERSION | Optional, wenn die Version anderweitig eindeutig verwaltet wird |
tests/ | Dringend empfohlen |
docs/ | Ab mittlerer Projektgröße sinnvoll |
.env.example | Bei konfigurierbaren Anwendungen empfehlenswert |
| Docker | Optional, abhängig von der Anwendung |
| CI/CD | Für größere oder regelmäßig veröffentlichte Projekte sinnvoll |
Es geht nicht darum, möglichst viele Dateien anzulegen.
Eine gute Entwicklungsumgebung ist nicht die mit der größten Verzeichnisstruktur, sondern diejenige, die zum Projekt passt und konsequent gepflegt wird.
Fazit: Gute Software beginnt mit guter Organisation
Moderne KI-Assistenten können die Softwareentwicklung erheblich beschleunigen.
Doch Geschwindigkeit allein ist kein Qualitätsmerkmal.
Ohne eine nachvollziehbare Projektstruktur entstehen schnell Abhängigkeiten, technische Altlasten und schwer wartbare Anwendungen.
Mit einigen grundlegenden Werkzeugen und Regeln lässt sich das vermeiden.
Eine gepflegte README, klare KI-Anweisungen in AGENTS.md, ein aussagekräftiges Changelog, Git-Versionierung, automatisierte Tests und eine konsequente Trennung zwischen Entwicklung und Produktion bilden dafür eine solide Grundlage.
Das gilt für kleine Hobbyprojekte genauso wie für umfangreichere Anwendungen.
Mein wichtigstes Fazit: Je mehr Programmierarbeit eine KI übernimmt, desto wichtiger werden klare Regeln, definierte Verantwortlichkeiten und eine nachvollziehbare Versionsverwaltung.
Dabei spielt es keine entscheidende Rolle, ob ein einzelner KI-Assistent sämtliche Aufgaben übernimmt oder mehrere spezialisierte Systeme zusammenarbeiten. Wichtig ist, dass Planung, Implementierung, Tests und Freigabe als eigenständige Arbeitsschritte organisiert werden.
Gerade die Kombination aus definierten Projektregeln und unterschiedlichen KI-Arbeitsmodi eröffnet auch Hobbyentwicklern die Möglichkeit, ihre Softwareentwicklung deutlich professioneller zu gestalten. Denn am Ende entscheidet nicht die Menge des erzeugten Codes über die Qualität eines Projekts, sondern wie zuverlässig sich dieser Code verstehen, testen, warten und weiterentwickeln lässt.




Hinterlasse einen Kommentar